
ทุกครั้งที่มีโมเดล AI ตัวใหม่ ฟีดจะเต็มไปด้วยตัวเลขคะแนน คำว่า "ดีที่สุด" และคลิปเดโมสวยๆ จนแยกไม่ออกว่าอะไรคือข้อเท็จจริง อะไรคือการตลาด และที่สำคัญกว่านั้นคือ เราใช้ได้ไหม ต้องจ่ายเท่าไร
Gemini 4 Argon คือโมเดลตัวใหม่ของ Google ที่ประกาศเมื่อ 30 ก.ย. 2026 และเปิดให้ใช้กว้างขึ้นเมื่อ 13 ต.ค. 2026 บทความนี้แยกให้เห็นว่าข้อมูลไหนมาจากหน้าทางการของ Google ข้อไหนยังไม่มีใครยืนยัน แล้วพาลองใช้ทั้งในแอปและผ่าน API พร้อมวิธีคิดค่าใช้จ่ายเองก่อนรันจริง
จบบทความนี้คุณจะ:
- รู้ว่า Gemini 4 Argon ทำอะไรได้ และตัวเลขสเปกแต่ละตัวหมายถึงอะไร
- อ่านตัวเลขผลงานที่ Google รายงานได้อย่างมีสติ
- รู้ว่าใครใช้ได้บ้าง และลองในแอป Gemini ได้ยังไง
- ขอคีย์ ติดตั้ง SDK และเรียก API ครั้งแรกด้วย Python หรือ JavaScript
- คำนวณค่าใช้จ่ายต่อคำสั่งได้เอง ทั้งราคาช่วงเปิดตัวและหลัง 1 ธ.ค. 2026
ตัวเลขทั้งหมดเป็นของวันที่ 25 ต.ค. 2026 ข้อมูลมาจากหน้าทางการ (blog.google และเอกสาร Gemini API ที่ ai.google.dev) ตัวเลขผลงานเป็นสิ่งที่ Google รายงานเอง ยังไม่เห็นผลทดสอบอิสระ และราคาจะขึ้นหลัง 30 พ.ย. 2026 เช็กหน้าเอกสารล่าสุดก่อนใช้จริงทุกครั้ง
Gemini 4 Argon คืออะไร
Google บอกว่า Argon เป็นโมเดลแนวหน้าตัวใหม่ ที่เน้นสามงาน คืองานวิศวกรรมซอฟต์แวร์ งานความรู้ในองค์กรอย่างกฎหมายและการเงิน และงานป้องกันภัยไซเบอร์ ส่วนเอกสาร API เรียกมันว่าโมเดลเรือธงด้านการคิดวิเคราะห์ (flagship reasoning model) สำหรับงานซอฟต์แวร์ที่ซับซ้อน คณิตศาสตร์ วิทยาศาสตร์ และเอเจนต์ที่ทำงานหลายขั้นตอน
| สเปก (จากเอกสาร Gemini API) | ค่า |
|---|---|
| รหัสโมเดล | gemini-4-argon (สถานะ Stable) |
| รับเข้า | ข้อความ รูป วิดีโอ เสียง และ PDF |
| ตอบออก | ข้อความอย่างเดียว |
| หน้าต่างบริบท | 1,048,576 token ใช้ร่วมกันทั้งอินพุต การคิด และเอาต์พุต |
| เอาต์พุตปกติ | สูงสุด 65,536 token (ขยายได้เกือบทั้งหน้าต่างด้วยโหมดรันเบื้องหลัง) |
| ระดับการคิด | low, medium (ค่าเริ่มต้น), high |
| ความสามารถอื่น | เรียกฟังก์ชัน ผลลัพธ์แบบมีโครงสร้าง ค้นด้วย Google Search รันโค้ด และ Batch API |
Token คือหน่วยที่โมเดลใช้นับข้อความ เทียบง่ายๆ ว่าเป็นชิ้นส่วนของคำ ส่วน หน้าต่างบริบท เหมือนขนาดโต๊ะทำงานของโมเดล ทุกอย่างที่เราส่งไป ทุกอย่างที่มันคิด และทุกอย่างที่มันตอบ ต้องวางบนโต๊ะตัวเดียวกันนี้
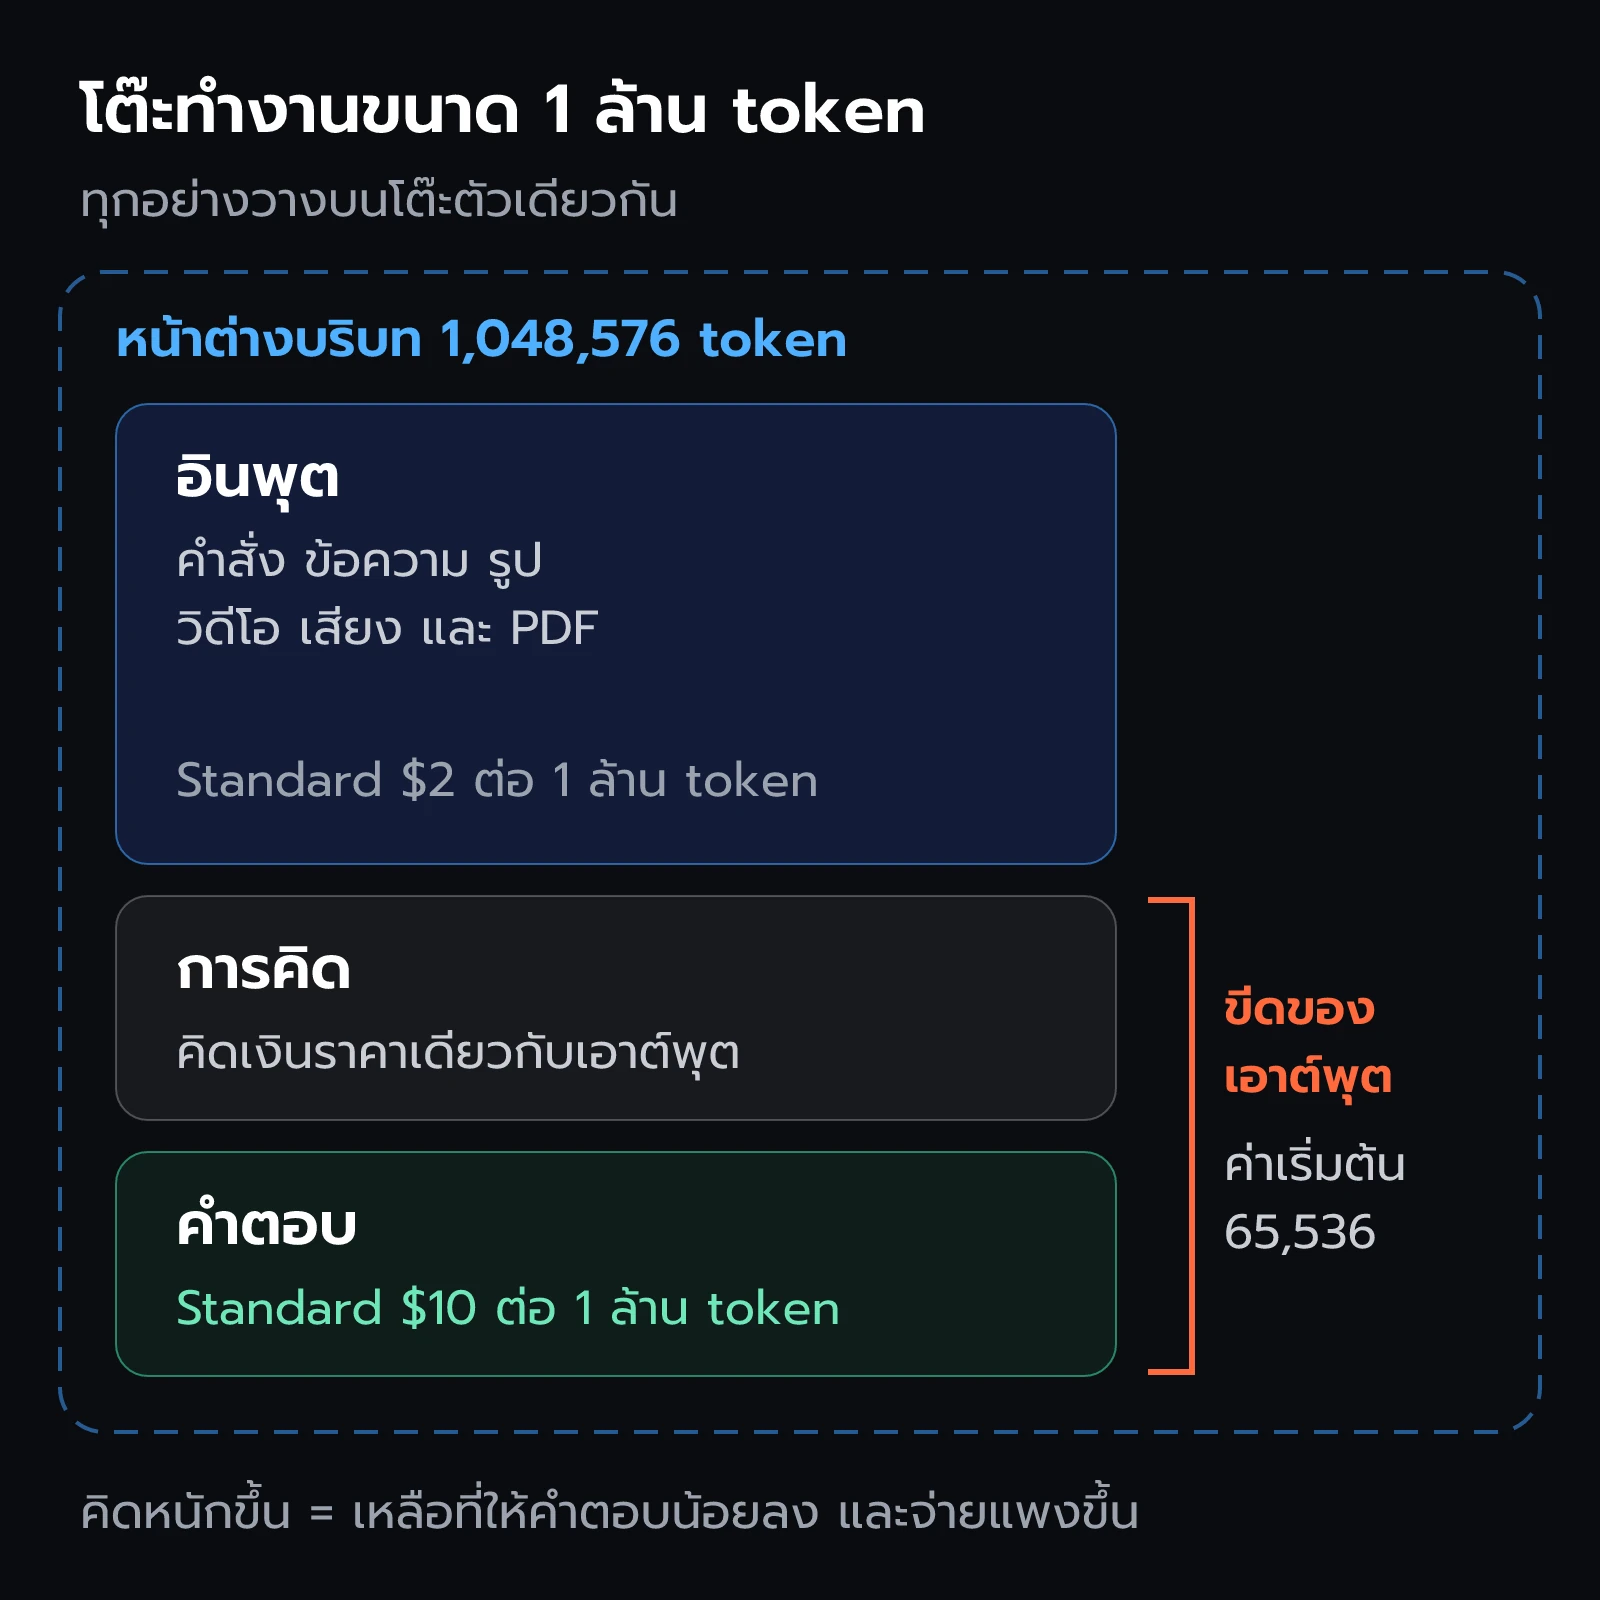
จุดที่คนเข้าใจผิดบ่อยคือคิดว่า 1 ล้าน token คือความยาวคำตอบ ที่จริงคือขีดรวมของทุกอย่าง และ token ที่ใช้คิดถูกนับเป็นเอาต์พุตด้วย ถ้าตั้งให้คิดหนัก ส่วนที่เหลือสำหรับคำตอบจะน้อยลง
อ่านตัวเลขผลงานยังไง
ในโพสต์ประกาศ Google รายงานตัวเลขเหล่านี้
| ชุดทดสอบ | สิ่งที่วัด | ที่ Google รายงาน |
|---|---|---|
| DeepSWE v1.1 | งานวิศวกรรมซอฟต์แวร์ | 77.9% (เรียกว่าสูงสุดในขณะนี้) |
| AutomationBench (Zapier) | งานอัตโนมัติ | 51.3% อันดับ 1 |
| LVBench | ความเข้าใจวิดีโอยาว | 91.7% |
| CWE-bench v1 | การแก้ช่องโหว่ | 68% เสมออันดับ 1 |
| Vals Index | ดัชนีรวม | บอกว่าอันดับ 1 ไม่ได้ให้ตัวเลข |
| ERQA | การคิดเรื่องร่างกายและพื้นที่ | 87% |
Google ยังเล่าตัวอย่างงานจริง เช่น ใช้ช่วยรีแฟกเตอร์โค้ดเก่าของ Chromium ราว 6 ล้านบรรทัดในหลายร้อยไฟล์ ซึ่งบอกว่าจาก "งานเป็นเดือนเหลือเป็นสัปดาห์" ทำให้ Gemma 4 E2B บน GPU A100 เร็วขึ้น 2.85 เท่า (จากราว 37,900 เป็นกว่า 108,000 token ต่อวินาที โดยผลลัพธ์ตรงกับของเดิม 100%) และสร้างงาน 3 มิติโดยคุม Blender ผ่าน MCP แล้วใช้ Three.js ทำฟิสิกส์ แสง และเสียง (อ่านเรื่อง MCP ได้ที่ MCP คืออะไร)
ตัวเลขดี ไม่เท่ากับดีกับงานของเรา ตัวเลขทั้งหมดนี้ Google รายงานเอง ยังไม่เห็นการทดสอบอิสระ และชุดทดสอบแต่ละชุดวัดงานแบบเฉพาะ ก่อนจ่ายเงินจำนวนมาก ให้เตรียมโจทย์จริงของเราสัก 10–20 ข้อ แล้วลองเทียบกับโมเดลที่ใช้อยู่เอง
ใครใช้ได้บ้าง
| กลุ่ม | ทางเข้า | หมายเหตุ |
|---|---|---|
| นักพัฒนา | Gemini API ผ่าน Google AI Studio และ Android Studio | ต้องเป็นแผนเสียเงิน ไม่มีในระดับฟรี |
| องค์กร | Gemini for business, API, Google Antigravity | – |
| สมาชิก Google AI Pro และ Ultra | แอป Gemini และ AI Mode ใน Search | – |
| สมาชิก Ultra | Google Antigravity | – |
| นักวิทยาศาสตร์ | สมัครขอใช้ Antigravity ระดับสูงสุดฟรี 6 เดือน | ต้องผ่านการคัดเลือก |
| นักป้องกันไซเบอร์ | โปรแกรม Fairwind (รุ่นที่ไม่มีตัวกันด้านไซเบอร์) | เปิดเฉพาะผู้ที่ได้รับเลือก |
หน้าประกาศไม่ได้พูดถึงผู้ใช้แอปแบบฟรี และไม่ได้ระบุขีดจำกัดการใช้ในแอป เงื่อนไขตามประเทศ หรือราคาสมาชิก เรื่องพวกนี้ต้องดูในหน้าแผนของ Google เอง
ลองในแอป Gemini
- เช็กแผน ต้องเป็นสมาชิก Google AI Pro หรือ Ultra
- เปิดแอป Gemini แล้วใช้แชตหลัก Google บอกว่า Argon ตอบตรงขึ้นและลังเลน้อยลง
- ลองโหมด Tasks เปิดได้จากแชต Google บอกว่าโหมดนี้ทำงานแทนเราได้แม้เราไม่ได้อยู่หน้าคอม
- ถ้าเขียนโค้ด หน้าจอเขียนโค้ดของ Google Antigravity อยู่ในแอป Gemini บน macOS สลับระหว่างแชตกับโค้ดได้
แอป Gemini ยังเชื่อมกับแอปอื่นได้มากกว่า 40 แอป เช่น Instacart, OpenTable, Adobe และ Shopify ถ้าไม่เห็นตัวเลือกโมเดลใหม่ ให้อัปเดตแอป และเช็กว่าแผนเป็น Pro หรือ Ultra
ลองผ่าน Gemini API
ขอคีย์และเปิดการเรียกเก็บเงิน
- ขอคีย์ ที่หน้า API keys ของ Google AI Studio ผู้ใช้ใหม่จะได้โปรเจกต์และคีย์ให้อัตโนมัติ หรือสร้างคีย์ใหม่เองได้
- เปิดการเรียกเก็บเงิน เพราะ Argon ไม่มีในระดับฟรี ทำตามขั้นตอนบนหน้าจอของ Google
- ตั้งวงเงินหรือการแจ้งเตือนค่าใช้จ่าย ในบัญชีก่อนรันอะไรจริงจัง กันบิลบานปลาย
คีย์ API คือรหัสผ่านที่ผูกกับบัตรเครดิต ห้ามใส่คีย์ในโค้ดที่อัปขึ้น GitHub ห้ามส่งให้ใคร และถ้ารั่วให้ลบแล้วสร้างใหม่ทันที ใครได้คีย์ไปก็ใช้โมเดลแล้วส่งบิลมาที่เราได้ ดูคลิปนี้ประกอบได้ครับ
ติดตั้ง SDK และตั้งคีย์
pip install -U google-genainpm install @google/genaiSDK จะอ่านคีย์จากตัวแปรสภาพแวดล้อมชื่อ GEMINI_API_KEY เอง จึงไม่ต้องเขียนคีย์ลงในโค้ด
export GEMINI_API_KEY="YOUR_API_KEY"$env:GEMINI_API_KEY="YOUR_API_KEY"ทั้งสองแบบตั้งค่าชั่วคราวเฉพาะหน้าต่างนั้น ปิดหน้าต่างแล้วหาย (เอกสาร quickstart แสดงเฉพาะคำสั่งของ macOS/Linux ส่วนคำสั่งของ PowerShell เป็นวิธีทั่วไปของ Windows)
เรียกครั้งแรก
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Explain how AI works in a few words",
)
print(interaction.output_text)python test.pyถ้าใช้ JavaScript ให้ตั้งชื่อไฟล์เป็น .mjs เพื่อใช้ import และ await ได้ตรงๆ
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const interaction = await ai.interactions.create({
  model: "gemini-4-argon",
  input: "Explain how AI works in a few words",
});
console.log(interaction.output_text);node test.mjsgenai.Client() สร้างตัวเชื่อมต่อโดยอ่านคีย์จาก GEMINI_API_KEY แล้ว interactions.create ส่งคำสั่งไปให้โมเดล gemini-4-argon ผลลัพธ์ที่ได้คือข้อความตอบสั้นๆ (เนื้อหาเปลี่ยนไปทุกครั้งที่รัน) ถ้ารันแล้วค้างนาน ไม่ต้องตกใจ โมเดลคิดก่อนตอบ งานยากใช้เวลาหลายนาทีได้
เช็กว่าได้แล้ว: รันแล้วได้ข้อความตอบกลับพิมพ์ออกมา โดยไม่มี error เรื่องคีย์หรือโมเดล
ตั้งระดับการคิด
ระดับการคิดกำหนดว่าโมเดลจะคิดนานแค่ไหนก่อนตอบ คิดมากขึ้นมักตอบดีขึ้นในงานยาก แต่ช้าลงและแพงขึ้น เพราะ token ที่ใช้คิดนับเป็นเอาต์พุต เอกสารแนะนำให้ลองทั้งสามระดับ แล้วเลือกระดับต่ำสุดที่คุณภาพยังพอ
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Summarize this paragraph in one sentence: ...",
    generation_config={"thinking_level": "low"},
)
งานยาวหรือโค้ดซับซ้อน เอกสารแนะนำให้รันเบื้องหลัง (background: true) และตั้ง max_output_tokens เป็น 131,072 หรือ 262,144 และถ้าเรียกแบบรอผล ให้ตั้ง timeout ของโปรแกรมฝั่งเราอย่างน้อย 15 นาที
ราคาและวิธีคิดค่าใช้จ่าย
ราคาต่อ 1 ล้าน token จากหน้า pricing ของ Gemini API (อินพุต / เอาต์พุตที่รวมการคิด)
| ระดับ | ถึง 30 พ.ย. 2026 | ตั้งแต่ 1 ธ.ค. 2026 |
|---|---|---|
| Standard | $2 / $10 | $4 / $20 |
| Batch | $1 / $5 | $2 / $10 |
| Flex | $1 / $5 | $2 / $10 |
| Priority | $3.60 / $18 | $7.20 / $36 |
- ไม่มีระดับฟรี สำหรับ Gemini 4 Argon
- อินพุตที่แคช Standard คิด $0.10 ต่อ 1 ล้าน token (หลัง 1 ธ.ค. เป็น $0.20) แคชเกิดอัตโนมัติกับคำสั่งตั้งแต่ 4,096 token ขึ้นไป ไม่รองรับการสั่งแคชเอง
- ค้นด้วย Google Search ฟรี 5,000 ครั้งต่อเดือน (ใช้ร่วมกับโมเดล Gemini 3 ขึ้นไป) หลังจากนั้น $14 ต่อ 1,000 ครั้ง
สูตรคิดค่าใช้จ่ายต่อหนึ่งคำสั่ง
ค่าใช้จ่าย = (I / 1,000,000) × ราคาอินพุต + (O / 1,000,000) × ราคาเอาต์พุต

I = จำนวน token อินพุต
O = จำนวน token เอาต์พุต (รวม token ที่ใช้คิด)| ตัวอย่าง (คำนวณเอง) | ราคาเปิดตัว | หลัง 1 ธ.ค. 2026 |
|---|---|---|
| อินพุต 100,000 + เอาต์พุต 10,000 | $0.30 | $0.60 |
| อินพุต 1,000,000 + เอาต์พุต 50,000 | $2.50 | $5.00 |
| แบบแรก 1,000 ครั้ง | $300 | $600 |
ดูแถวแรกเป็นตัวอย่าง ราคาเปิดตัวคือ 0.1 × $2 + 0.01 × $10 = $0.20 + $0.10 = $0.30 จะเห็นว่าเอาต์พุตแพงกว่าอินพุต 5 เท่า และ token ที่ใช้คิดนับเป็นเอาต์พุต การลดระดับการคิดจึงเป็นวิธีประหยัดที่ได้ผลที่สุด รองลงมาคือใช้ Batch หรือ Flex กับงานที่ไม่รีบ ซึ่งถูกกว่า Standard ครึ่งหนึ่ง
คำนวณจากตัวเลขจริงของงานเรา ช่วงทดลอง ให้จดจำนวน token ที่ API รายงานกลับมาในแต่ละครั้ง แล้วคูณกับราคาของช่วงหลัง 1 ธ.ค. ด้วย จะได้งบที่ใช้วางแผนได้จริง ไม่ต้องตกใจตอนราคาขึ้น
ย้ายมาจากรุ่นก่อน ต้องแก้อะไร
| สิ่งที่เปลี่ยน | ต้องทำ |
|---|---|
| ไม่รองรับการสั่งแคชเอง | ลบ cached_content และการสร้างแคชออกจากคำขอ ใช้แคชอัตโนมัติแทน |
temperature, top_p, top_k | ลบออก ถ้าใส่มาจะถูกเมิน |
| บทสนทนาหลายรอบ | ใช้ previous_interaction_id ให้เซิร์ฟเวอร์เก็บสถานะ |
การคิดนับใน max_output_tokens | ถ้าเคยตั้งต่ำกว่า 32K ให้เพิ่มเป็นอย่างน้อย 32,768 หรือลดระดับการคิดแทน |
| งานยากใช้เวลานาน | รันเบื้องหลัง หรือตั้ง timeout อย่างน้อย 15 นาที |
ข้อควรระวังและแก้ปัญหา
- ตัวเลขผลงานเป็นของ Google เอง ลองกับงานจริงของเราก่อนตัดสินใจ
- ราคาขึ้นเท่าตัวตั้งแต่ 1 ธ.ค. 2026 วางงบด้วยราคาใหม่ไว้ก่อน
- 1 ล้าน token คือขีดรวม ไม่ใช่ความยาวคำตอบ คำตอบปกติสูงสุด 65,536 token
- ระวังข้อมูลลับ ข้อมูลที่ส่งผ่าน API ถูกประมวลผลโดย Google อ่านเงื่อนไขการใช้ข้อมูลของบริการก่อนส่งข้อมูลสำคัญ ถ้าต้องการให้ข้อมูลอยู่ในเครื่องจริงๆ ดูทางเลือกแบบ Ollama
| อาการ | สาเหตุ | วิธีแก้ |
|---|---|---|
ไม่พบโมเดล gemini-4-argon | พิมพ์ชื่อผิด หรือบัญชียังไม่มีสิทธิ์ | เทียบชื่อกับหน้าเอกสารของโมเดล |
| ขึ้นว่าใช้ระดับฟรีไม่ได้ | Argon ไม่มีในระดับฟรี | เปิดการเรียกเก็บเงินในบัญชี |
| error เรื่องคีย์ | ยังไม่ได้ตั้ง GEMINI_API_KEY ในหน้าต่างนี้ | ตั้งตัวแปรใหม่ แล้วรันในหน้าต่างเดียวกัน |
| คำขอหมดเวลา | งานยากใช้เวลานาน | ตั้ง timeout อย่างน้อย 15 นาที หรือรันเบื้องหลัง |
| คำตอบหยุดกลางคัน | ชน max_output_tokens ซึ่งนับรวมการคิด | เพิ่มค่า หรือลดระดับการคิด |
ใส่ cached_content แล้วพัง | ไม่รองรับการสั่งแคชเอง | ลบออก ใช้แคชอัตโนมัติ |
ไปต่อ
- เอกสารโมเดล Gemini 4 Argon และ สิ่งที่เปลี่ยนในรุ่นนี้
- หน้าราคา และ Quickstart ของ Gemini API
สรุป
- Gemini 4 Argon (
gemini-4-argon) คือโมเดลเรือธงด้านการคิดของ Google เน้นงานซอฟต์แวร์ งานความรู้ในองค์กร และงานป้องกันไซเบอร์ - หน้าต่างบริบท 1,048,576 token ใช้ร่วมกันทั้งอินพุต การคิด และเอาต์พุต คำตอบปกติสูงสุด 65,536 token
- ตัวเลขผลงานเป็นสิ่งที่ Google รายงานเอง ลองกับงานจริงก่อนตัดสินใจ
- ใช้ได้ในแอป Gemini สำหรับสมาชิก AI Pro/Ultra และผ่าน API แบบเสียเงินเท่านั้น เรียกด้วย
interactions.createและอ่านคีย์จากGEMINI_API_KEY - ราคา Standard $2/$10 ต่อ 1 ล้าน token ถึง 30 พ.ย. แล้วเป็น $4/$20 คิดค่าใช้จ่ายด้วยสูตร (I/1M × ราคาอินพุต) + (O/1M × ราคาเอาต์พุต)
พร้อมแล้วก็ไปทำ Quiz ท้ายบทด้านล่างเพื่อรับ XP ได้เลยครับ